
把 300 页 PDF 拆成章节,而不重新压缩
拆分是页复制,不是重新导出:什么都不重编码,但总体积会变大、大纲会消失、印刷页码会对不上。怎么切,才能让每一份都能单独用。
300 页的报告、手册或扫描合集,作为一份文件几乎没用:会计要财务那一段,法务要附件,打印的人只要交给客户的十页。拆分就是把这一个文件变成那几份的操作。它也是最容易让人对体积感到意外的操作,因为每一份都是完整的新文档——自带一份字体、自带元数据,而且完全没有大纲。
拆分是页复制,不是重新导出
工具只载入源文件一次,然后为每个分段写出一份新 PDF:把属于这一段的页面复制进去。不解码、不重绘、不重编码图片——每页的内容流和资源都是原样交给新文档的。这是好消息,也是为什么说拆分对扫描件是安全操作:300 页切 12 章之后,每一份的文字层、图片和分辨率都和原来一样。
不那么好的消息是「完整的新文档」要付的代价。每个分段都自带文档级结构,它页面上用到的任何资源都必须存在于这一段里。原来只嵌入一次的字体子集,会在每一个用到它的分段里再嵌入一次。对拉丁文字文档来说,这常常是每份 40–200 KB 的重复字体数据;而带中日韩字体子集或大色彩配置文件的 PDF,每份可能要多出 1 MB 以上。
| 项目 | 拆成 12 份之后 |
|---|---|
| 页面内容、图片、文字层 | 与源文件完全一致。没有任何重编码,所以画质不会下降。 |
| 嵌入字体与色彩配置文件 | 被复制进每一个用到它们的分段,因此各份加起来比原件更大。 |
| 书签(大纲) | 没了。每一份都是新文档,目录是空的。 |
| 表单字段 | 字段定义住在文档目录里,所以即使还能画出来,也已经不能填写。 |
| 元数据 | 每份都有新的生成器和日期;源文件的历史不会跟过来。 |
| 页码 | 每份都从 1 重新开始。原来是 61–90 页的那一份,第一页会显示第 1 页。 |
先找边界,再动手
拆分难的一直不是那个按钮,而是你得知道「第 4 章从印刷页码 61 开始」这件事对应到 PDF 的第几页——可能是第 67 页,也可能因为前面用了罗马数字而是第 3 页。这一步搞错,切出来的每一份都会偏六页,而且这个错误直到有人发现某章从半句话开始才会暴露。
- 直接搜章节标题本身(「第 4 章」「附件 B」,或那行标题的原文)。阅读器会跳到文字所在的那一页,那就是你要切在它前面的页。
- 记下阅读器显示的页号,以及纸上印的页号,把偏移量记住——例如印的 61 是查看器的 67,那么整份文档的偏移就是 +6。
- 如果是没有文字层的扫描件,就没得搜:从缩略图上读印刷页码,套用你从第一章算出来的偏移量。
- 动手之前,把切点写成一个列表:「在第 N 页之前」。分三次凭记忆拆,是文档出现重复页的标准原因。
开始切
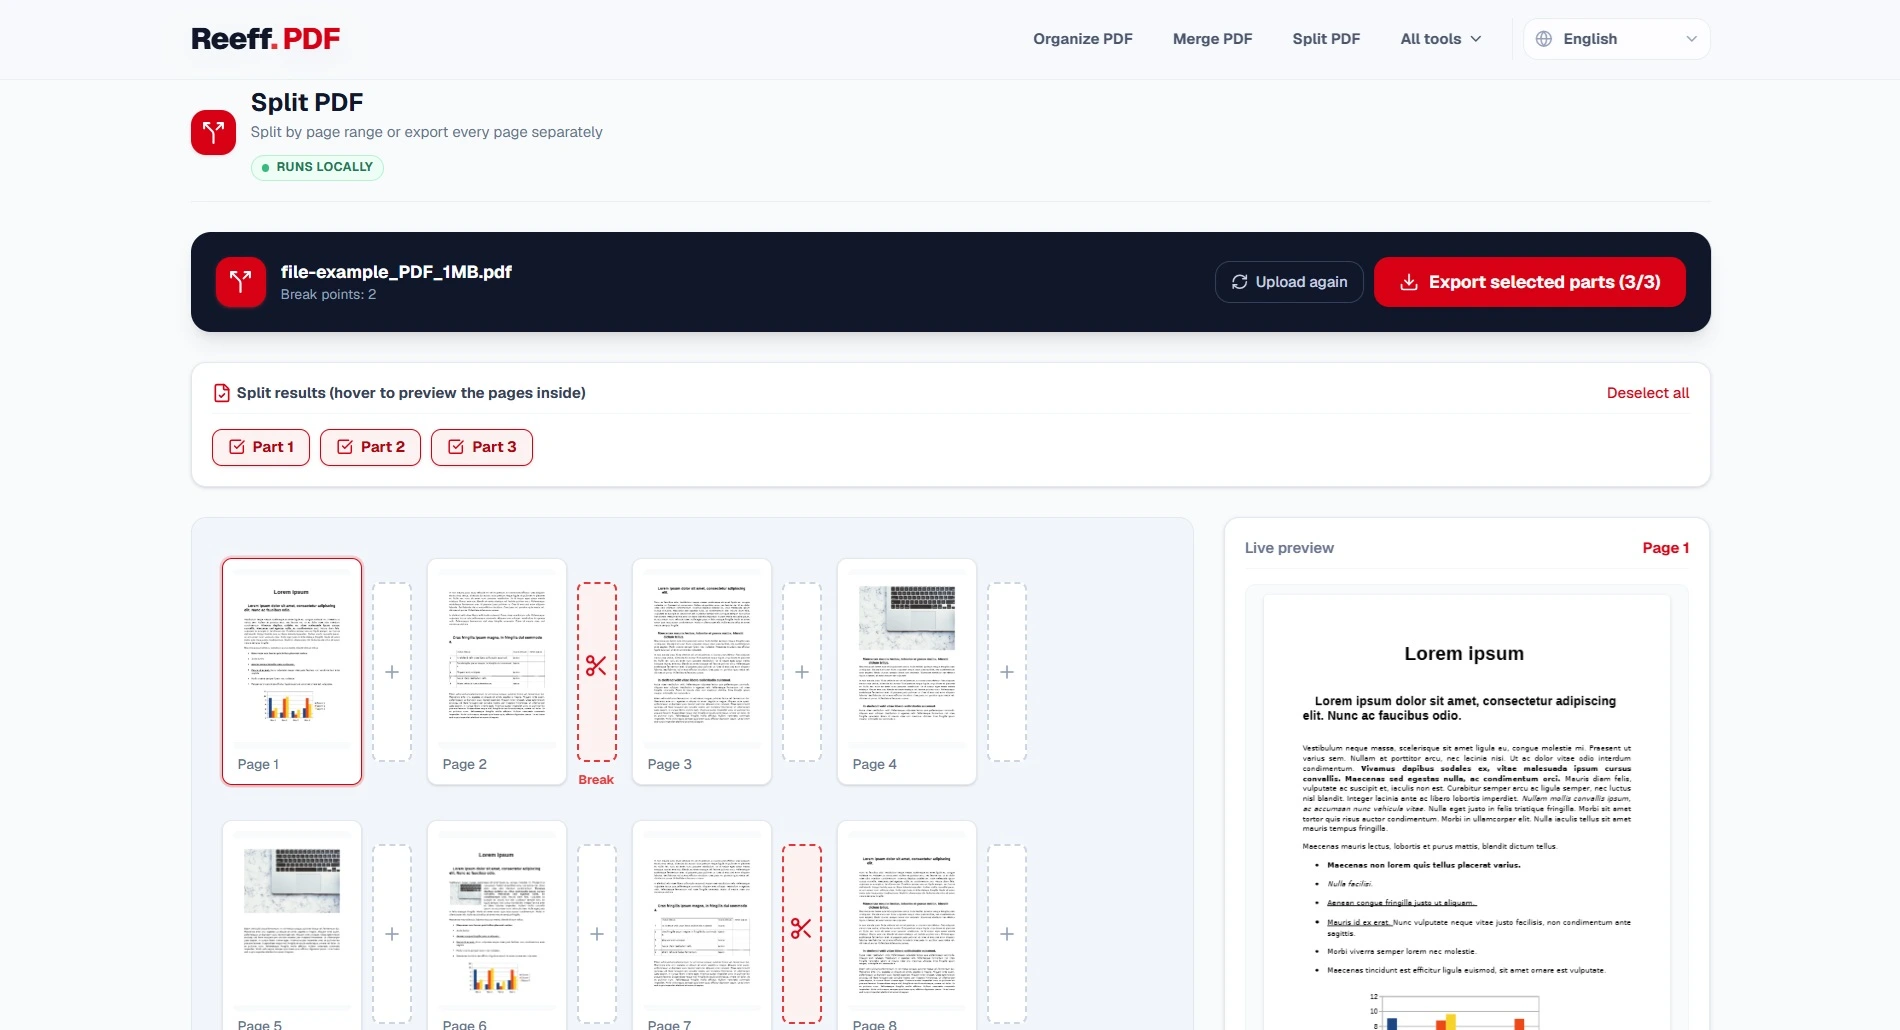
01先加文件,让它数页数
确认页数和阅读器报的一致。本该 300 页却载入成 298 页,说明有两页损坏,而它们之后的每个切点都跟着移位了。
02设的是切点,不是区间
拆分是按断点工作的:在第 30 页之后切一刀,意思是 1–30 页成为第一份、31 页往后是第二份。12 章只需要 11 个切点,不是 12 个——第一段永远从第 1 页开始,最后一段永远到最后一页结束。
03下载之前就改好名字
一堆叫 report-1.pdf 到 report-12.pdf 的文件,一周后就没法用了。保存时顺手改名,把章号放在最前面,文件夹才能正确排序;超过九份时保留补零(02、03 … 12)。
每一份都要检查什么
- 把所有分段的页数加起来,和源文件对。12 份加起来是 299 页,说明有一页在某个边界上丢了。
- 读每一份的第一行。某一章从半句话开始,就是你记的页码偏移量差了一位——这是拆分最常见的错误。
- 在其中一份里搜一个你确定属于这一章的词。拆分保留文字层,所以一定搜得到;搜不到说明这份文件在拆分之前就已经被栅格化了。
- 把最小的一份在手机上打开。打不开通常是页复制时没带上某个资源——不常见,但这是最便宜的检查方式。
- 看文件夹里的排序对不对:02 必须排在 10 前面,这只有在你保留了补零时才会成立。
什么时候不该拆分
- 你只要 300 页里的一段:提取是一个操作,拆分给你的是十二份、还得再删掉十一份。
- 你要给这些页面换页码规则、加页眉、重建大纲:那是回源应用重新导出的事,不是 PDF 操作。任何页复制工具都变不出页码标签。
- 这些部分必须能一起被搜索:拆分破坏了原来的整体结构,从此每一份只能各自被搜到。
- 文档本身不到 20 页。拆成章节什么也没省下——一份带书签的文件才是更好的产物。
拆分值得做的前提是:每一份都有自己的负责人、自己的截止时间或自己的去处——附件给审计、手册给印厂、合同给客户。如果拆开只是为了钻过一个上传上限,那么压缩或裁剪文档是更小的改动。